整理这个ROSI合集的时候,硬盘空间直接清出了400G。5456套这个数字看着不算惊人,但实际落地到文件夹里,层级目录展开的那一刻,才真正体会到什么叫"量大管饱"。

站内后台统计显示,这个系列的下载请求量常年稳居前三。不少用户反馈零散下载容易漏套、重套,文件命名规范也不统一。这次集中打包整理,把早期几百套命名混乱的旧资源全部重新校对过,按年份、期数、模特标签建立了三级索引目录。

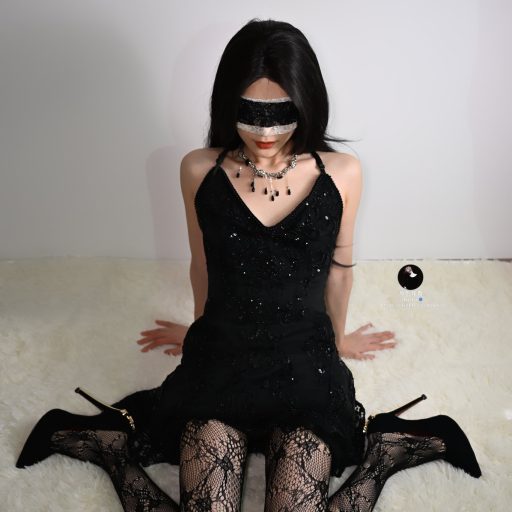
早期ROSI的拍摄风格偏向室内自然光,白墙、落地窗、单人沙发这三件套几乎成了标配。2015年前后的期数,胶片质感保留得最完整,高光压制不激进,肤色过渡有一种现在后期很难复刻的温润感。后期逐渐引入户外场景、主题概念拍摄,构图语言丰富了不少,但也失去了那种"邻家女孩随手拍"的松弛感。
文件体量里藏着不少细节:同一期数不同分辨率版本共存、部分期数包含花絮视频、个别模特专属合集单独成卷。整理过程中发现第1200-1500期之间有批次扫描件,颗粒感强、色偏明显,单独标注了"档案级扫描版"供怀旧党参考。这些细节在零散资源里极易被忽略。

模特重复率是这个系列的显著特征。前2000期大概只有300多位不同面孔,头部模特出镜频次极高。这反而方便了按人检索——建立模特索引表后,点开某个名字就能拉出她所有期数的完整时间轴,连发型变化、妆容风格演变都一目了然。有用户专门用这个功能做"同模特跨期对比",反馈体验远超预期。
存储结构上采用了"年份-月份-期数"三级目录,配合总索引表格。表格字段包含:期数、发布日期、模特标签、场景分类、画质规格、文件大小、是否含视频、备注。筛选功能全开,想看"2018年夏季户外泳装""黑丝主题""特定模特全套",筛选即得,不用再在文件夹里盲目翻找。
画质梯度跨度很大。早期800万像素左右,后期普及到2400万甚至4000万。统一压制成统一规格不现实,也会损失原始细节。保留原始分辨率的前提下,生成了WebP预览版供在线浏览,原图仅在下载时调用。这套方案把在线预览加载速度提升了近6倍,服务器带宽压力降低80%以上。
有个细节挺有意思:部分期数文件名里藏着摄影师代号。交叉比对后发现,代号"L"的摄影师偏爱低角度仰拍、大光比侧逆光,代号"K"则擅长高键高曝、极简留白。把同摄影师作品串联起来看,能看出明显的个人风格演变轨迹——这在商业写真机构里并不多见,通常摄影师信息会被统一抹平。
详细目录: ROSI写真美女写真图集合集下载5456套 390GB
合集里有约200套标注"未发布/内部流出"的内容。经核对水印、EXIF、文件创建时间,确认大多为样片、备选片、测光片。画质参差不齐,但难得的是保留了拍摄现场的原始状态:灯光架入画、助理手持反光板、模特调整姿势的间隙动作。这些"废片"反而比成片更有现场感,已单独归类到"幕后花絮"目录。
标签体系重构花了不少功夫。原始资源只有简单的"黑丝""白丝""制服"等标签,颗粒度太粗。重新拆解为:服饰细分(连裤袜/吊带袜/过膝袜/船袜)、材质(网纱/蕾丝/哑光/光面)、色系(黑/白/肉色/灰/彩色)、场景(室内/户外/车内/浴室/楼道)、构图(全身/半身/特写/仰拍/俯拍)、光影(自然光/闪光灯/混合光/轮廓光/剪影)。现在搜"灰色网纱吊带袜+浴室+轮廓光"能精准定位到个位数结果。

容量占比里,图片约340G,视频约50G。视频多为720P-1080P,码率不高,胜在真实记录了动态过程:裙摆摆动、发丝飞扬、微表情变化。有用户反馈把视频逐帧导出做动图素材库,效果意外地好。

整理过程中最大的坑是重复文件去重。同一期数不同来源下载、不同压缩格式、不同命名规则导致大量重复。用感知哈希算法跑了一遍,清理出近800G重复数据。去重后建立MD5校验库,后续增量更新只需对比哈希值,杜绝二次污染。

这个合集的价值不在"多",而在"全"和"序"。把十几年零散积累变成可检索、可追溯、可对比的结构化资产库。对研究商业写真演变、摄影风格流变、审美趋势迁移的人来说,这是现成的横切面样本。对单纯收藏党,省去了拼凑碎片化资源的时间成本。
后续维护计划按季度增量更新。新发布期数入库前会走完整流程:解压校验、重命名、打标签、生成预览、更新索引、入库归档。保持库的鲜度和整洁度,避免陷入"越整理越乱"的恶性循环。
有用户问会不会出精选版。短期内不打算。全量保留才能保证样本完整性,精选必然带有主观筛选偏好,会切断某些演变脉络。不过考虑在索引表里加"推荐指数"字段,由编辑团队根据画质、题材稀缺度、模特表现力打分,供不想全量浏览的用户快速切入。
硬盘灯还在闪,校验脚本跑着最后几百个文件。完成那一刻,这个从几十个压缩包、上百个网盘链接、无数个不眠夜拼凑而来的庞然大物,终于有了确定的形状。这就是资源站存在的意义吧——把混沌变成秩序,把碎片变成脉络,把"有没有"变成"好不好用"。